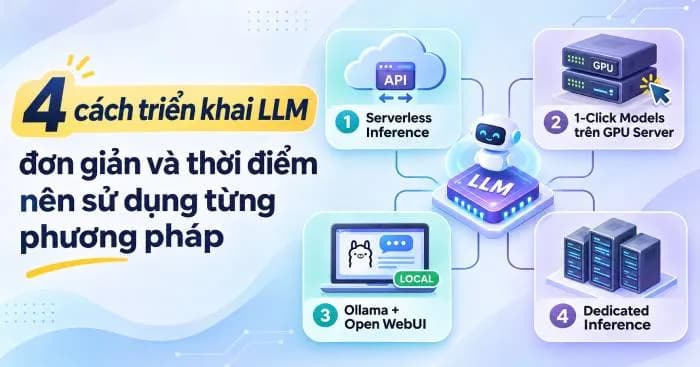
Việc đưa một mô hình ngôn ngữ lớn (LLM) vào môi trường sản xuất thực tế đòi hỏi nhiều bước hơn là chỉ tải về và chạy thử nghiệm. Doanh nghiệp cần cân nhắc kỹ lưỡng về hạ tầng phần cứng GPU, công cụ phục vụ mô hình (serving engine), cấu hình giao diện API cũng như khả năng mở rộng hệ thống khi lượng truy cập tăng trưởng mạnh mẽ.
Hiện nay thị trường cung cấp đa dạng giải pháp đưa AI vào vận hành, từ các dịch vụ API quản lý sẵn cho đến việc tự lưu trữ trên máy chủ chuyên dụng. Mỗi phương án đều sở hữu những đặc điểm riêng biệt về chi phí đầu tư, mức độ kiểm soát, hiệu năng xử lý và độ phức tạp trong khâu vận hành hàng ngày.
Dưới đây là bốn phương pháp triển khai LLM phổ biến hiện nay, phân tích chi tiết ưu nhược điểm và thời điểm phù hợp để áp dụng nhằm giúp tối ưu hóa hệ thống CNTT của doanh nghiệp.
Tổng quan về quy trình vận hành và cấu trúc triển khai LLM
Triển khai LLM (LLM deployment) bản chất là thiết lập môi trường để ứng dụng hoặc người dùng cuối có thể gửi yêu cầu và nhận kết quả phản hồi từ mô hình ngôn ngữ một cách ổn định.
Một hệ thống vận hành LLM tiêu chuẩn thường bao gồm bốn thành phần cốt lõi sau đây:
- Trọng số mô hình (Model weights): Bộ tham số đã qua huấn luyện quyết định năng lực tư duy và tạo lập nội dung của mô hình.
- Công cụ suy luận (Inference engine): Phần mềm chuyên dụng xử lý quá trình tính toán, điển hình như vLLM hoặc Ollama.
- Giao diện API: Cầu nối giúp các ứng dụng, website hoặc dịch vụ bên ngoài dễ dàng truyền tải yêu cầu.
- Hạ tầng phần cứng (GPU/CPU): Nguồn lực tính toán nền tảng để vận hành mô hình và đáp ứng lưu lượng người dùng.
Bên cạnh đó, việc thiết lập môi trường còn đòi hỏi các thành phần hỗ trợ như trình điều khiển GPU tương thích (ví dụ CUDA cho NVIDIA hoặc ROCm cho AMD) cùng các tiêu chuẩn mở rộng tài nguyên linh hoạt.
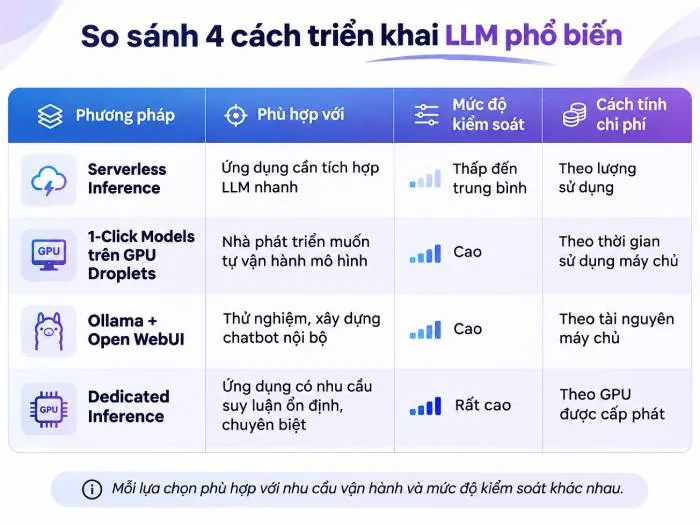
Giải pháp Serverless Inference cho ứng dụng tích hợp nhanh
Serverless Inference là phương án tối ưu khi doanh nghiệp muốn tích hợp sức mạnh của LLM vào phần mềm mà không cần bận tâm đến việc thiết lập hay quản trị máy chủ GPU phức tạp.
Thay vì tự xây dựng hạ tầng, hệ thống sẽ gửi các câu lệnh trực tiếp thông qua API do bên cung cấp dịch vụ quản lý toàn bộ quá trình vận hành hạ tầng phía sau.
Ưu điểm nổi bật của Serverless Inference
- Tốc độ triển khai tức thì: Không mất thời gian cấu hình phần cứng hay cài đặt driver.
- Khả năng tích hợp liền mạch: Dễ dàng kết nối vào ứng dụng qua giao diện API tiêu chuẩn.
- Sự linh hoạt cao: Cho phép thử nghiệm nhiều dòng mô hình khác nhau mà không tốn công cài đặt lại.
- Cơ chế thanh toán tối ưu: Tính tiền dựa trên lượng token thực tế tiêu thụ thay vì duy trì máy chủ liên tục.
- Tiết kiệm chi phí vận hành: Tính năng lưu bộ nhớ đệm prompt giúp giảm tải đáng kể chi phí cho các nội dung lặp lại.
Thời điểm nên áp dụng Serverless Inference: Phương án này phù hợp cho việc phát triển nhanh các trợ lý ảo, chatbot, công cụ xử lý văn bản, hoặc khi lượng truy cập biến động thất thường và chưa cần duy trì tài nguyên phần cứng độc quyền.
Sử dụng GPU Droplets để tự quản lý mô hình linh hoạt
Đối với các tổ chức đòi hỏi mức độ kiểm soát cao hơn đối với mô hình và môi trường vận hành, việc sử dụng các máy chủ GPU riêng biệt là lựa chọn đáng cân nhắc.
Các nền tảng hạ tầng hiện đại cung cấp tùy chọn khởi tạo nhanh với Docker và vLLM được cấu hình sẵn, giúp rút ngắn thời gian chuẩn bị môi trường ban đầu.
Ưu điểm khi vận hành trên GPU Droplets
- Chủ động hoàn toàn trong việc lựa chọn và tải các mô hình từ cộng đồng mã nguồn mở.
- Toàn quyền kiểm soát cấu hình hệ thống và tối ưu hiệu suất bằng các kỹ thuật như giải mã dự đoán hay lượng tử hóa bộ nhớ.
- Mô hình tính cước theo thời gian thuê thiết bị linh hoạt.
Thời điểm nên áp dụng: Thích hợp cho các đội ngũ kỹ thuật có chuyên môn muốn tự lưu trữ mô hình mã nguồn mở, tùy biến sâu cấu hình suy luận theo đặc thù riêng của sản phẩm.
Xây dựng chatbot nội bộ với Ollama kết hợp Open WebUI
Khi mục tiêu đặt ra là thiết lập môi trường thử nghiệm nội bộ hoặc xây dựng giao diện trò chuyện riêng tư cho doanh nghiệp, bộ đôi công cụ Ollama và Open WebUI mang lại giải pháp vô cùng hiệu quả.
Ollama đảm nhận vai trò chạy mô hình, trong khi Open WebUI cung cấp giao diện trực quan tương tự các nền tảng chat phổ biến giúp người dùng dễ dàng thao tác.
Ưu điểm của mô hình kết hợp này: Giao diện thân thiện không cần tự lập trình, môi trường tự lưu trữ bảo mật cao, cực kỳ lý tưởng để tạo ra các bản mẫu (prototype) đánh giá năng lực trước khi đưa vào sản phẩm chính thức.
Dedicated Inference cho hệ thống có tải trọng ổn định
Khi ứng dụng đã đạt được lượng truy cập ổn định với các yêu cầu khắt khe về độ trễ và hiệu năng xử lý, Dedicated Inference trở thành giải pháp chuyên dụng không thể thiếu.
Khác với các dịch vụ chia sẻ tài nguyên, phương pháp này cấp phát độc quyền một cụm GPU hoàn toàn dành riêng cho hệ thống của doanh nghiệp.
Ưu điểm cốt lõi của Dedicated Inference
- Tài nguyên tính toán không phải chia sẻ với bất kỳ khách hàng nào khác.
- Toàn quyền cấu hình endpoint riêng tư hoặc công khai tương thích chuẩn API hiện đại.
- Đáp ứng hoàn hảo các tác vụ có cường độ xử lý cao và liên tục.
Thời điểm nên áp dụng: Dành cho các hệ thống thương mại lớn, các dịch vụ AI vận hành 24/7 đòi hỏi sự cam kết tuyệt đối về tốc độ phản hồi và năng lực xử lý hạ tầng.
Góc nhìn chuyên gia kỹ thuật từ TTC Việt Nam
Nhận định từ các kỹ sư giải pháp mạng và viễn thông tại TTC Việt Nam: Trong bức tranh công nghệ hiện đại, việc lựa chọn sai phương pháp triển khai LLM có thể khiến doanh nghiệp rơi vào bài toán lãng phí ngân sách hoặc sập hệ thống khi lượng người dùng tăng đột biến. Lời khuyên cho các doanh nghiệp vừa và nhỏ là hãy bắt đầu từ các giải pháp Serverless hoặc GPU Droplets quy mô nhỏ để kiểm chứng hiệu quả sản phẩm. Khi ứng dụng đã chứng minh được giá trị thương mại và có lượng user ổn định, việc dịch chuyển lên hạ tầng Dedicated Inference chuyên dụng là bước đi chiến lược đảm bảo sự bền vững, an toàn dữ liệu và tối ưu hóa chi phí dài hạn.
Để được tư vấn giải pháp hạ tầng mạng, viễn thông và triển khai hệ thống AI tối ưu nhất cho doanh nghiệp của bạn, hãy liên hệ ngay với TTC Việt Nam hôm nay để nhận hỗ trợ chuyên sâu từ đội ngũ kỹ sư hàng đầu.